mu
μ · Only what's needed.
只给任务最需要的上下文的编码代理。基于 pi,由判定模型 Jev 在每一轮做三十多个小决定,大模型把注意力留给正事。
Jev 判定内核
每一轮,几百个和代码无关的决定
什么留在上下文里,一条命令安不安全,一个发现值不值得告诉另一个代理,活干完了没有。交给大模型,花的是 token、延迟和注意力;交给死规则,错得太多。mu 把它们交给 Jev:一个小而快的判定模型,每次只回答一个有边界的问题。答案只改变模型接下来做什么,从不改变它要不要问你。
你说话的时候
是新任务、追问,还是在纠正它?代理干活时的插话,要不要立刻打断?
工具返回的时候
长输出里哪几块现在有用。测试日志里失败的留下,刷屏的去掉。
开口的第一句
闲聊还是要动手的活?用不到的技能和 MCP 服务器不进上下文,需要时才打开。
动手之前
这条命令会不会造成不可逆的后果?有没有越过你定下的规矩?
上下文变长的时候
过期的结果直接丢,不用写摘要。所以上下文一直不满,缓存命中率一直高。
你纠正它的时候
这条值不值得记成经验?下次召回了有没有照做?没人照做的经验自己退役。
三十多个判定点,每个都能单独开关、单独换判定器(本地的 Laya,或任意一个大模型),每一次判定都留在流水里,随时可以翻。
蜂群
几只蜂一起干活,Jev 站在中间
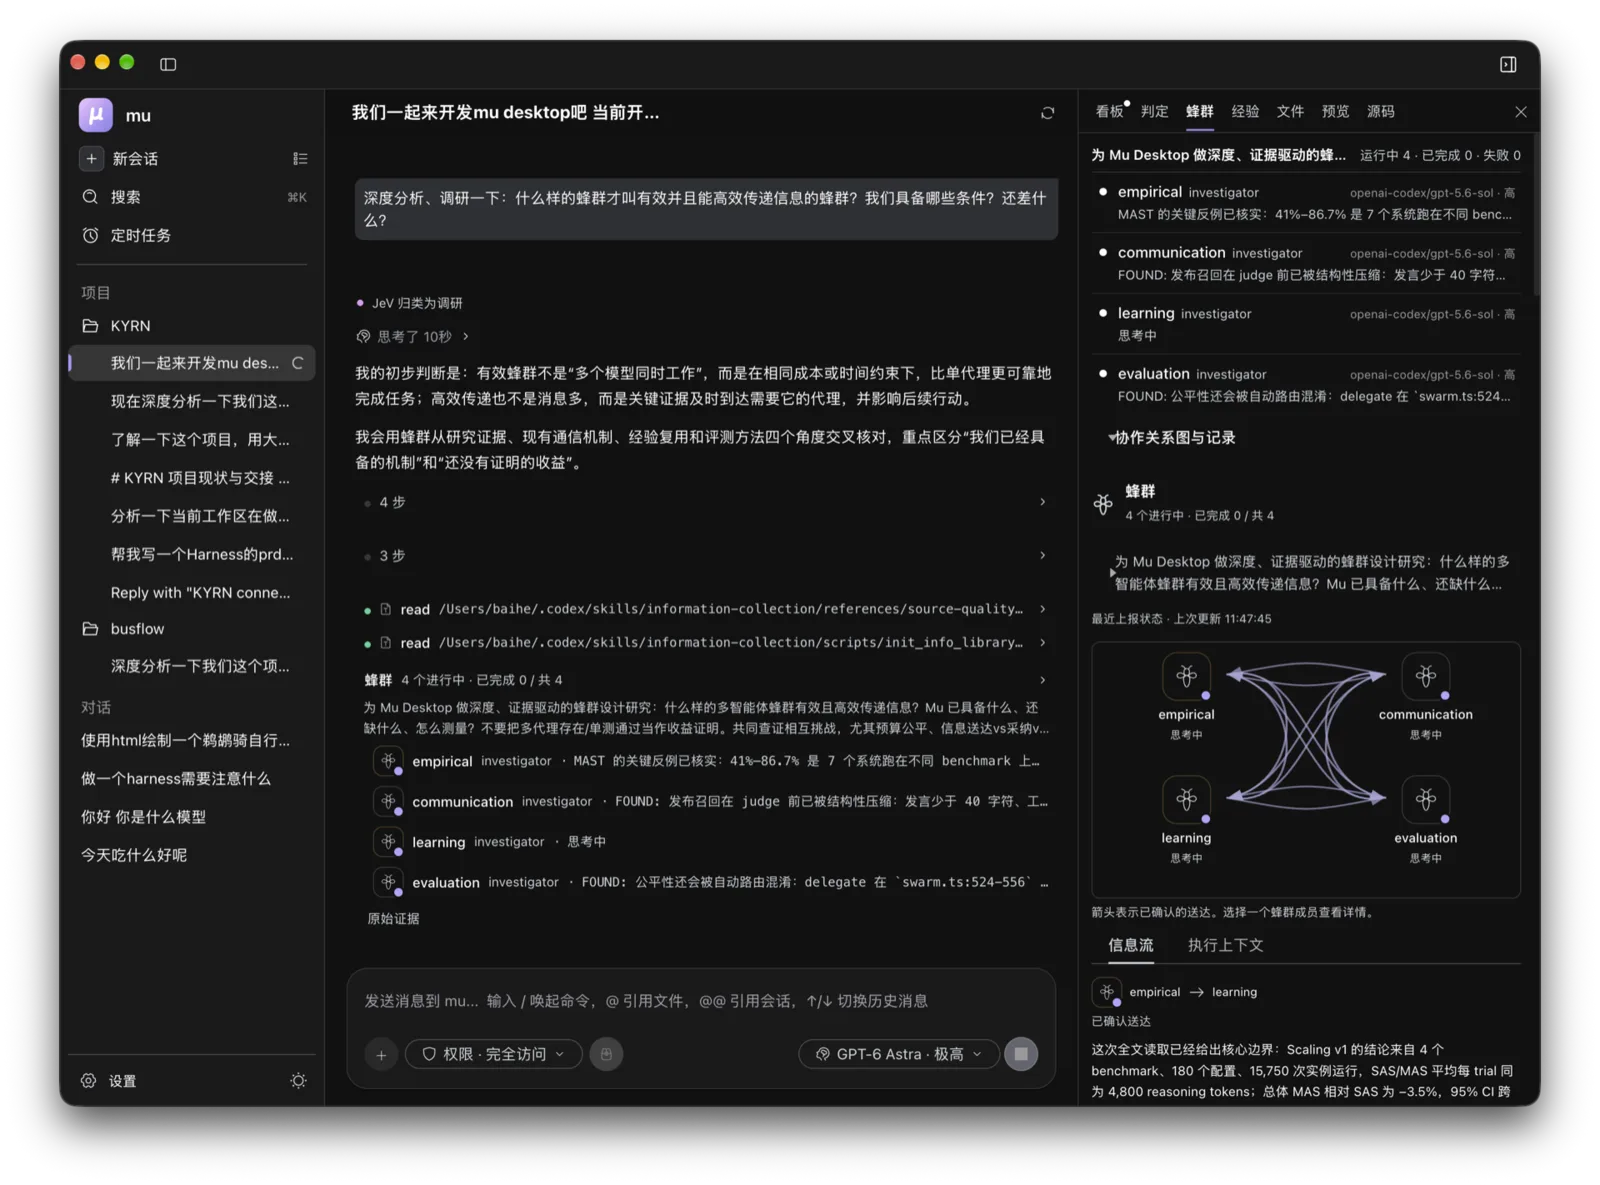
让几个代理一起啃一个难题,最难的不是派活,是交流。什么都不说,各自走进同一条死路;什么都说,每个人的上下文里全是别人的聊天。mu 的蜂群里,每一个发现 Jev 都判一次值不值得共享,只有对另一只蜂真有价值的信息,才会作为上下文传过去。
人话看板
干活和讲话,本来就不该是同一个模型的事
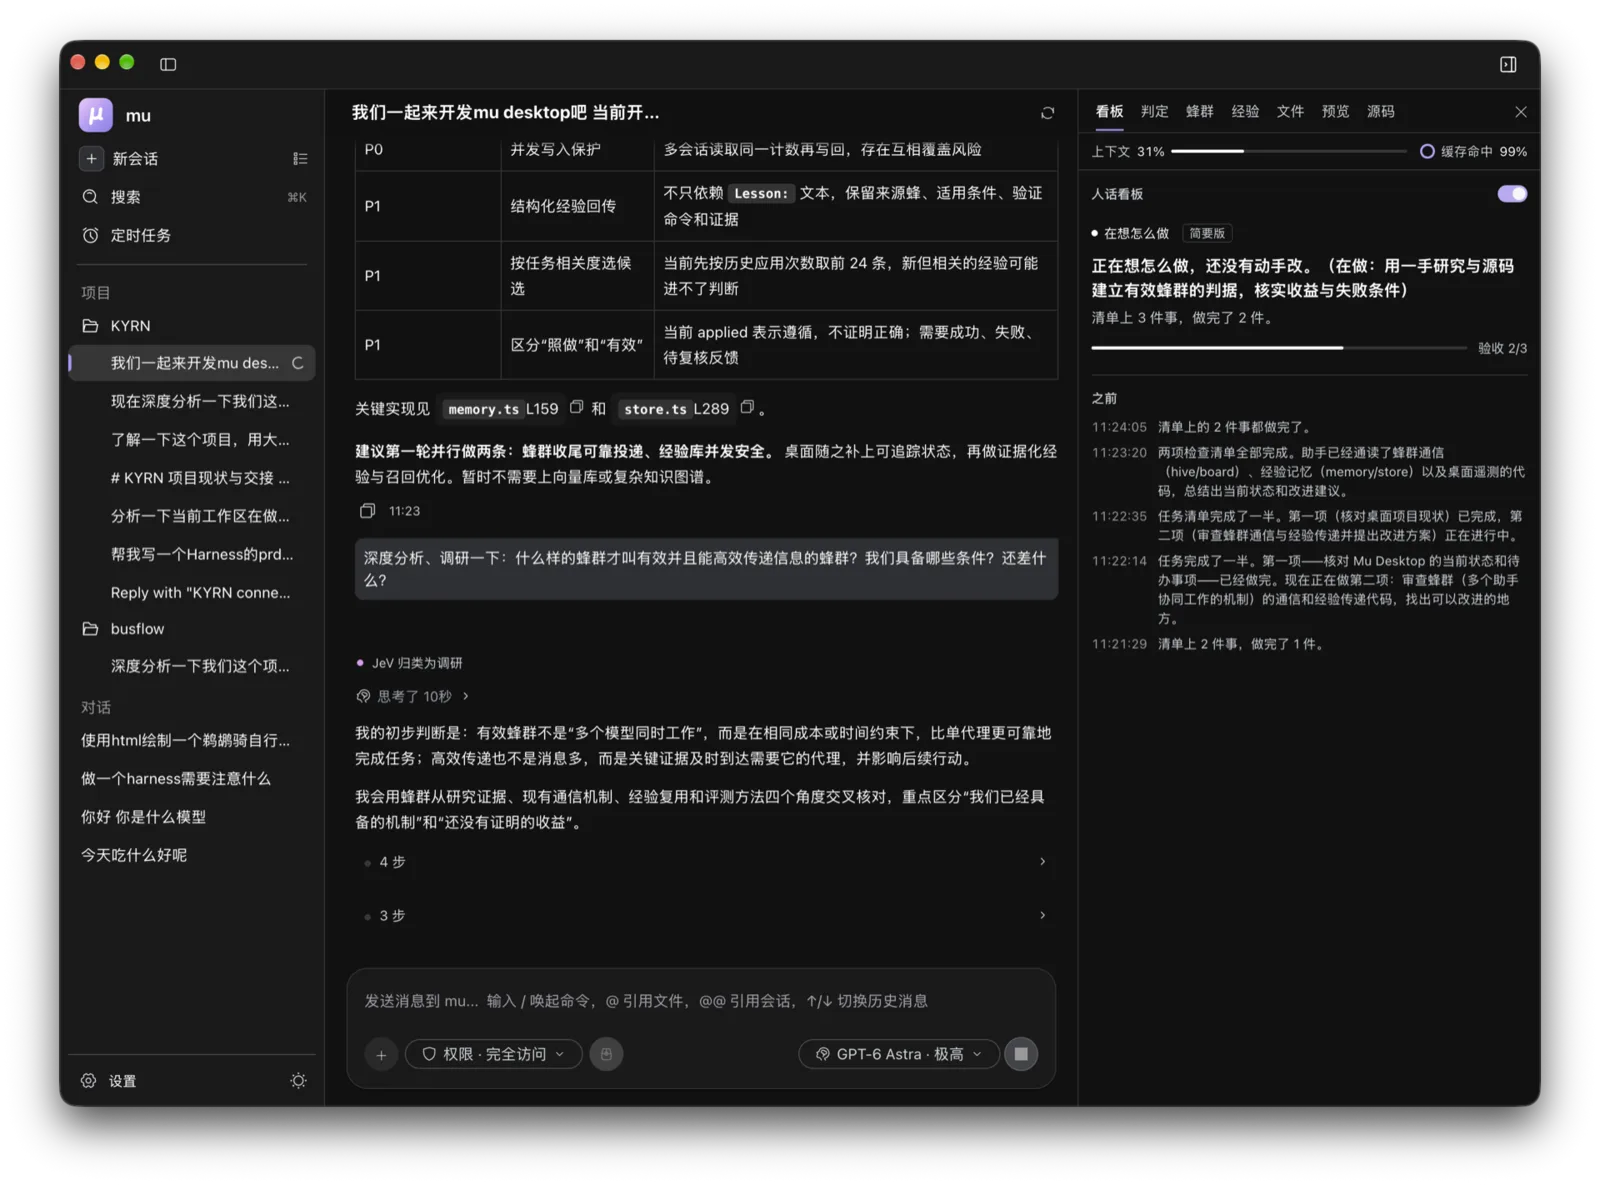
模型越来越强,汇报却越来越像写给机器看的。mu 里干活的模型照旧用它自己的语言干活;代理每做完一步,看板上多一行人话:改了哪个文件,检查过没过,跑了什么命令。它中途说的话,Jev 判一次算不算新消息,算,就交给一个专门因为说人话而选出来的模型当场重讲。运行结束时,你看到的不只是「做完了」,还有它到底做了什么。
还有这些
命令行和桌面端,共用一套账号、设置和经验
/goal <条件>,一直干到条件成立才停。Jev Key
送你一个 Jev Key,直接开始用 mu
我们拿出 2000 个 Jev Key 作为社区福利。每个公网 IP 限领一个,先到先得;领取后请自行妥善保存。
mu · Jev Key 福利
不需要注册、不需要小游戏。点一下领取,把 Key 粘贴进 mu 即可。
桌面端粘贴到「设置 → 内核 → 判定器」;命令行写入 ~/.mu/.env:TYPESAFE_API_KEY=你的Key。
想用自己的 Key?
也可以到 TypeSafe 注册并创建自己的 API Key,额度和价格以 TypeSafe 控制台为准。
创建 API Key
在控制台新建一个 key,复制下来。
交给 mu
桌面端:首次启动的引导页,或「设置 → 内核 → 判定器」里粘贴。命令行:在 ~/.mu/.env 里写一行 TYPESAFE_API_KEY=你的key。
用 Vercel AI Gateway 的 key 也行(AI_GATEWAY_API_KEY)。暂时没有 key 也能用:本地判定器 Laya,或任意一个大模型,都可以接管判定点。